9.19.2015

Python: How to Implement Thread-Safe Auto-Increment in Redis

Python: Redis上でスレッドセーフなオート・インクリメントを実現する


目的

Redisで以下のような3種類のDBを使い、色々な名前の登録処理をしたい。

  • 名前 -> ID の検索テーブル
  • ID -> 名前 の検索テーブル
  • 特定の key で ID の登録数 (=払い出したIDの最大値) を保持するテーブル

ID は 1 を起点とするオート・インクリメントなもので、名前ごとにユニークな数値を割り当てる。


インターフェース

1個の Redis インスタンスの中にある 3つの DBを使用する想定。それぞれのDB番号とカウンターとして使用するキーの名前を指定して初期化。

register メソッドは文字列として name を受け取り、その name に対応するユニークな ID を返す。name が DB に登録されていない場合のみ、登録処理を行う。

import redis


class Registerer(object):
    def __init__(self, counter_key, db_counter, db, db_invert=None,
                 host='localhost', port=6379):
        self.counter_key = counter_key
        self.db_counter = db_counter
        self.db = db
        self.db_invert = db_invert
        self.host = host
        self.port = port
        self.redis = redis.Redis(host, port, db)
        self.redis_cnt = redis.Redis(host, port, db_counter)
        self.redis_inv = (redis.Redis(host, port, db_invert)
                          if db_invert is not None else None)

    def register(self, name):
        return ???


テスト

マルチスレッド・プログラミングをする時はテストがないと不安なので、先にテストを書く。
(実行すると、ローカルの Redis のデータは全て消える)

#!/usr/bin/env python
import unittest
import threading

from repos.registerer import Registerer


class TestRegisterer(unittest.TestCase):
    def _clear(self):
        self.r.redis.flushall()

    def setUp(self):
        self.num_records = 10000
        self.r = Registerer('count', 15, 14, 13)
        self._clear()

    def tearDown(self):
        self._clear()

    def test_register_serial(self):
        r = self.r
        for i in range(self.num_records):
            r.register('user-%04d' % i)

        for i in range(10):
            r.register('user-%04d' % i)

        self.assertEqual(r.redis.dbsize(), self.num_records)
        self.assertEqual(r.redis_inv.dbsize(), self.num_records)
        self.assertEqual(int(r.redis_cnt.get('count')), self.num_records)

        for i in range(100):
            self.assertEqual(int(r.redis.get(r.redis_inv.get(i * 50 + 1))), i * 50 + 1)
            self.assertEqual(r.redis_inv.get(i * 50 + 1), 'user-%04d' % (i * 50))

    def test_register_parallel(self):
        r = self.r
        threads = [threading.Thread(target=r.register, args=('user-%04d' % i,)) for i in range(10000)]

        for t in threads:
            t.start()

        for t in threads:
            t.join()

        self.assertEqual(r.redis.dbsize(), self.num_records)
        self.assertEqual(r.redis_inv.dbsize(), self.num_records)
        self.assertEqual(int(r.redis_cnt.get('count')), self.num_records)

        for i in range(100):
            self.assertEqual(int(r.redis.get(r.redis_inv.get(i * 50 + 1))), i * 50 + 1)

            # this will fail
            # self.assertEqual(r.invert_redis.get(i * 50 + 1), 'user-%04d' % (i * 50))

    def test_register_parallel_same_id(self):
        r = self.r
        threads = [threading.Thread(target=r.register, args=('user-0000',)) for _ in range(self.num_records)]

        for t in threads:
            t.start()

        for t in threads:
            t.join()

        self.assertEqual(r.redis.dbsize(), 1)
        self.assertEqual(r.redis_inv.dbsize(), 1)
        self.assertEqual(int(r.redis_cnt.get('count')), 1)
        self.assertEqual(int(r.redis.get('user-0000')), 1)
        self.assertEqual(r.redis_inv.get(1), 'user-0000')


if __name__ == '__main__':
    unittest.main()


ナイーブな実装 (問題あり)

名前 -> ID のテーブルを検索し、値が取得できなかったら Redis の INCR コマンドで値を更新し、その ID を正引き/逆引きのテーブルそれぞれ登録する。

念の為に SETNX コマンドを利用し、キーが既に存在していたら例外を送出するようにする。

    def register_naive(self, name):
        index = self.redis.get(name)
        if index is None:
            index = self.redis_cnt.incr(self.counter_key)
            if not self.redis.setnx(name, index):
                raise Exception(
                    'Failed to register: db=%d, key=%s, value=%s' %
                    (self.db, name, index))
            if self.db_invert is not None:
                if not self.redis_inv.setnx(index, name):
                    raise Exception(
                        'Failed to register: db=%d, key=%s, value=%s' %
                        (self.db_invert, index, name))
        return int(index)

Redis の INCR はアトミックな処理であるし、一見問題はなさそうだが、先程書いたテストが失敗する。

.Exception in thread Thread-10001:
Traceback (most recent call last):
  File "/Users/xxxxxx/.pyenv/versions/2.7.9/lib/python2.7/threading.py", line 810, in __bootstrap_inner
    self.run()
  File "/Users/xxxxxx/.pyenv/versions/2.7.9/lib/python2.7/threading.py", line 763, in run
    self.__target(*self.__args, **self.__kwargs)
  File "/xxxxxx/registerer.py", line 36, in register_naive
    raise Exception('Failed to register: db=%d, key=%s, value=%s' % (self.db, name, index))
Exception: Failed to register: db=14, key=user-0000, value=1

F.
======================================================================
FAIL: test_register_parallel_same_id (__main__.TestRegisterer)
----------------------------------------------------------------------
Traceback (most recent call last):
  File "./tests/test_registerer.py", line 72, in test_register_parallel_same_id
    self.assertEqual(int(r.redis_cnt.get('count')), 1)
AssertionError: 2 != 1

----------------------------------------------------------------------
Ran 3 tests in 9.492s

FAILED (failures=1)

これは、同じ名前を同時に大量に登録した場合にのみ発生する。
名前 -> IDテーブルのチェックと更新の間のタイミングで競合状態が発生し、同じ名前の登録処理が複数実行されているためである。


トランザクションを利用した実装

redis-py には transaction というお誂え向きのヘルパーメソッドが用意されている。

パイプラインを引数に取る関数と、楽観的ロックをかけるキーを指定するだけでシンプルにトランザクションを記述できる。

最終的なコードは以下のようになった。

import redis


class Registerer(object):
    def __init__(self, counter_key, db_counter, db, db_invert=None,
                 host='localhost', port=6379):
        self.counter_key = counter_key
        self.db_counter = db_counter
        self.db = db
        self.db_invert = db_invert
        self.host = host
        self.port = port
        self.redis = redis.Redis(host, port, db)
        self.redis_cnt = redis.Redis(host, port, db_counter)
        self.redis_inv = (redis.Redis(host, port, db_invert)
                          if db_invert is not None else None)

    def register(self, name):
        def f(pipe):
            index = self.redis.get(name)
            if index is None:
                index = pipe.incr(self.counter_key)
                if not self.redis.setnx(name, index):
                    raise Exception(
                        'Failed to register: db=%d, key=%s, value=%s' %
                        (self.db, name, index))
                if self.db_invert is not None:
                    if not self.redis_inv.setnx(index, name):
                        raise Exception(
                            'Failed to register: db=%d, key=%s, value=%s' %
                            (self.db_invert, index, name))
            return int(index)

        return self.redis_cnt.transaction(
            f, self.counter_key, value_from_callable=True)


無事、テストも通った。

...
----------------------------------------------------------------------
Ran 3 tests in 13.818s

OK


References

9.18.2015

Image Conversion Cheat Sheet

画像変換チートシート


コマンドラインで画像変換を完結するためのメモ。

9.02.2015

Getting Started with Apache Spark Cluster and GraphX

Spark クラスタを 10分 で構築して GraphX を試してみる


ローカルモードで動かした後の次のステップ

前提条件

  • OS: Mac or Linux
  • JDK: 7+


インストール

  • Downloads | Apache Spark
    • 既に構築済みの Hadoop クラスタがあれば、それに応じたパッケージタイプを選択。
    • 「Pre-built for Hadoop 2.6 and later」あたりを選べば無難。
    • Scala 2.11 を使いたい場合はソースからのビルドが必要。
  • パッケージを選択した場合、ダウンロードしたファイルを展開すればすぐに使える。
  • Spark 一式は /usr/local/share/spark として使う。(以降、適当に読み替えること)
  • log4j.properties ファイルを作成して、不要な INFO ログを抑止する。

実行例

# ### ダウンロードと展開、移動
# curl -O http://d3kbcqa49mib13.cloudfront.net/spark-1.4.1-bin-hadoop2.6.tgz
# tar zxf ./spark-1.4.1-bin-hadoop2.6.tgz
# mv -i ./spark-1.4.1-bin-hadoop2.6 /usr/local/share/spark-1.4.1
#
# ### シンボリックリンクを作成
# ln -s /usr/local/share/spark-1.4.1 /usr/local/share/spark
#
# ### ロギング設定
# cd /usr/local/share/spark
# cp -pi ./conf/log4j.properties.template ./conf/log4j.properties
# vi ./conf/log4j.properties
# diff ./conf/log4j.properties.template ./conf/log4j.properties
2c2
< log4j.rootCategory=INFO, console
---
> log4j.rootCategory=WARN, console


起動

Hadoop, HDFS が使えなくても Spark の利用は可能。

クラスタの管理サービスにはいくつか選択肢がある。

  • Amazon EC2
  • Standalone Deploy Mode
  • Apache Mesos
  • Hadoop YARN

今回は、一番簡単な Standalone Deploy Mode を試す。

  • マスター起動
    # /usr/local/share/spark/sbin/start-master.sh
  • スレーブ起動
    # /usr/local/share/spark/sbin/start-slave.sh "spark://マスターのIPアドレス:7077"
    マスターのIPアドレスの箇所はホスト名でもよいが、localhost, 127.0.0.1 はデフォルトで接続が拒否されている模様。
    マスターとの同居も可。


動作確認

  • ログ
    • /usr/local/share/spark/logs 配下に master, worker それぞれのログファイルが作成される。
  • GUI
    • http://マスターのIPアドレス:8080
      Spark Master at spark xxxxxxxx 7077


build.sbt

必要最低限のものだけ。

name := "your-app-name"

version := "0.1.0"

scalaVersion := "2.10.4"

libraryDependencies ++= Seq(
  "org.apache.spark" %% "spark-core" % "1.4.1",
  "org.apache.spark" %% "spark-graphx" % "1.4.1"
)


データ

@teppei_tosa さんのチュートリアルに従う。

1 2
2 3
3 1


ソースコード

import org.apache.spark._
import org.apache.spark.SparkContext
import org.apache.spark.SparkContext._
import org.apache.spark.graphx._
import org.apache.spark.rdd.RDD

object Main {
  def main(args: Array[String]) = {
    val conf = new SparkConf().setMaster("spark://MASTER_IP:7077").setAppName("My Application")
    val sc = new SparkContext(conf)

    val g = GraphLoader.edgeListFile(sc, "path/to/edge_list.txt").cache()

    g.vertices.collect().foreach(println(_))
    g.edges.collect().foreach(println(_))
    sc.stop()
  }
}

実行

$ sbt run
(snip)

(3,1)
(1,1)
(2,1)

(snip)

Edge(1,2,1)
Edge(2,3,1)
Edge(3,1,1)

INFO ログが大量に出て見にくいが、無事グラフの情報が画面に出力された。

Python3.2: TypeError in subprocess Module When Using Bytes Command String

Python3.2: subprocess モジュールでコマンドラインを bytes で書くと TypeError が発生


事象

POSIX互換環境の Python 3.2 で subprocess#call を呼び出すとき
コマンドを bytes で書きつつ shell モードを有効にすると、以下の意味不明なエラーが出る。

$ python
Python 3.2.5 (default, Sep  1 2015, 23:07:07)
[GCC 4.2.1 Compatible Apple LLVM 6.1.0 (clang-602.0.53)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
>>> import subprocess
>>> subprocess.call(b'echo', shell=True)
(snip)
TypeError: Can't convert 'int' object to str implicitly
>>>

コマンドを str で渡せばよいのだが、それだとコマンドライン自体が SJIS などの非UTF-8で表現されている場合に困ってしまう。


原因

子プロセスを生成するところで、args に ['/bin/sh', '-c', 101, 99, 104, 111] というパラメータが渡っていた。
['/bin/sh', '-c'] + list(b'echo') のようなコードで作られたようだ。

1バイトごとに分解され int となったものが暗黙的に str に変換されずに TypeError が送出される。

Python 3.3 では修正済み。


対応方法

Python 3.2 をサポートしないのが賢明と思われるが、以下のようなワークアラウンドでも回避できそうだ。

import subprocess


NOT_USE_SHELL = sys.version_info[:2] == (3, 2) and not sys.platform == 'win32'

cmd = b'echo'

if NOT_USE_SHELL:
    ret_code = subprocess.call(['/bin/sh', '-c', cmd], shell=False)
else:
    ret_code = subprocess.call(cmd, shell=True)


話題になったのが 5年以上前ということもあり、Google検索しても情報が出てこないのがつらい。

8.31.2015

SSH Cheat Sheet

SSH チートシート


たまに使うけど忘れがちなコマンド & tips についてメモ。

Easy Menu 1.0 is Now Released!

新しく生まれ変わった Easy Menu をお試しください


Easy Menu とは

Easy Menu とは、設定ファイルを元にターミナル上で動作するコマンドランチャーを立ち上げるだけの、とてもシンプルなツールです。

実に 2 年以上の間ずっと放置していたのですが意外と社内で好評でしたので、この際リニューアルしてみました。

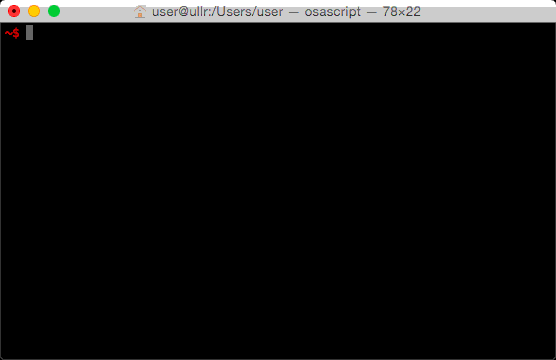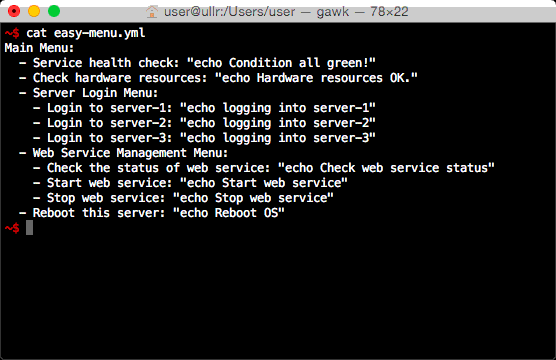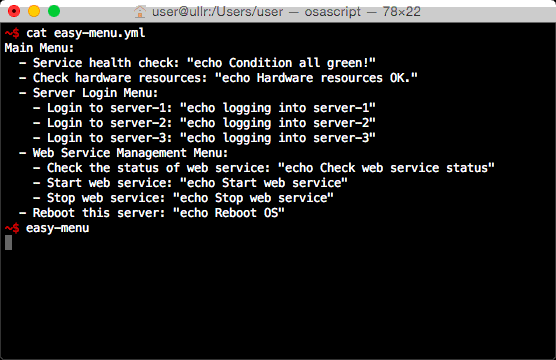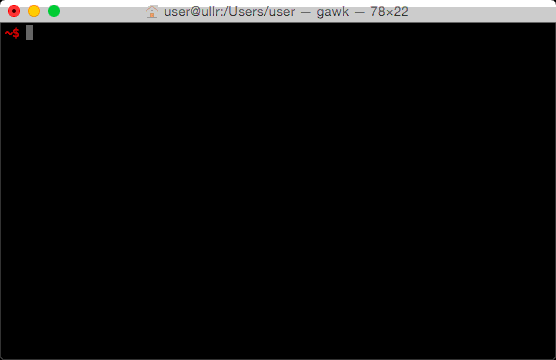
  • 動作イメージ


すぐに試す

今回、パッケージを PyPI に登録することができたので、インストールがとても簡単になりました。

設定ファイルを HTTP(S) 経由で取得すれば、たった 2行のコマンドで Easy Menu をお試しいただけます。

注意: 2015-08-31時点では、まだ Python 3.x系には対応していません
=> 2015-09-02 にリリースした v1.0.2 で Python 3.2/3.3/3.4 に対応しました

pip install easy-menu
easy-menu http://git.io/vGWla


主な起動方法
  • easy-menu
    • パラメータを付けずにコマンドを実行した場合、カレントディレクトリから上位に向かって easy-menu.yml が存在するかチェックしていきます。そして最初に見つかった設定ファイルの内容がロードされます。 (Vagrant における Vagrantfile の検索と同じような動きです)
    • 環境変数 EASY_MENU_CONFIG を設定することで、検索対象のファイル名
      (デフォルトは easy-menu.yml) を変更することもできます。
    • プロジェクトのルートディレクトリに easy-menu.yml を置いておくと捗ります。
  • easy-menu <設定ファイルのパス>
    • もちろん、設定ファイルの場所を直接指定することもできます。
      尚、コマンド実行時には、設定ファイルの存在するディレクトリにカレントディレクトリを移動してからコマンドが実行されます。
  • easy-menu <設定ファイルのURL>
    • http(s) により設定ファイルをネットワーク上から取得します。
    • スキームは http, https のみ対応。省略はできません。


新機能


1行のコマンドでインストール

前述のとおり、pip コマンドでインストールできるようになりました。

YAML形式のサポート

これまでは JSON のみのサポートでしたが、YAML にも対応しました。

別ファイルのインクルード

"include" というキーワードを使うことで、別のファイルのメニューをマージすることが可能になりました。

設定イメージ:

---
メインメニュー:
  - include: common.yml
  - サブメニュー:
    - コマンド3: echo 3
    - コマンド4: echo 4
---
共通メニュー:
  - コマンド1: echo 1
  - コマンド2: echo 2

この場合、以下のようにメニューが生成されます。

---
メインメニュー:
  - 共通メニュー:
    - コマンド1: echo 1
    - コマンド2: echo 2
  - サブメニュー:
    - コマンド3: echo 3
    - コマンド4: echo 4


動的なメニュー生成

"eval" というキーワードを使うことで、任意のコマンドをメニュー生成時に実行し、その標準出力を YAML 形式の設定として読み込むことが可能になりました。

設定イメージ:

---
メインメニュー:
  - eval: scripts/create_ec2_menu.sh

この場合、シェルスクリプト create_ec2_menu.sh の出力がそのままメニューの内容として反映されます。

例えば、AWS で起動中の EC2 インスタンスの一覧を動的に取得するような使い方を想定しています。

国際化対応

現状、対応しているのは英語と日本語のみです。


以上、簡単な機能の紹介でした。
不具合、要望などがありましたら、お気軽に GitHub Issue に登録をお願いします。

8.23.2015

Running Apache Spark Cluster by using Kubernetes

Kubernetes を使って Spark クラスタを立ち上げる


環境


インストール


Kubernetes のインストール (NG)

適当なプロジェクト用ディレクトリに移動し、以下のコマンドを実行。

$ export KUBERNETES_PROVIDER=vagrant
$ curl -sS https://get.k8s.io | bash

早速コケた。

Downloading kubernetes release v1.0.3 to /proj/mogproject/example-spark/kubernetes.tar.gz
--2015-08-23 10:39:46--  https://storage.googleapis.com/kubernetes-release/release/v1.0.3/kubernetes.tar.gz
Resolving storage.googleapis.com... 216.58.220.176
Connecting to storage.googleapis.com|216.58.220.176|:443... connected.
HTTP request sent, awaiting response... 200 OK
Length: 121767360 (116M) [application/x-tar]
Saving to: ‘kubernetes.tar.gz’

100%[===============================================================================>] 121,767,360 1.76MB/s   in 65s

2015-08-23 10:40:51 (1.80 MB/s) - ‘kubernetes.tar.gz’ saved [121767360/121767360]

Unpacking kubernetes release v1.0.3
Creating a kubernetes on vagrant...
Starting cluster using provider: vagrant
... calling verify-prereqs
... calling kube-up
Using credentials: vagrant:vagrant
Bringing machine 'master' up with 'virtualbox' provider...
Bringing machine 'minion-1' up with 'virtualbox' provider...
==> master: Box 'kube-fedora21' could not be found. Attempting to find and install...
    master: Box Provider: virtualbox
    master: Box Version: >= 0
Request for box's Amazon S3 region was denied.

This usually indicates that your user account with access key ID


is misconfigured. Ensure your IAM policy allows the "s3:GetBucketLocation"
action for your bucket:

    arn:aws:s3:::opscode-vm-bento

どうやら vagrant up コマンドに失敗している模様。
認証周りを管理しているプラグイン vagrant-s3auth をアンインストールしたら、先に進んだ。

$ vagrant plugin uninstall vagrant-s3auth

しかし、今度はこの画面から一向に進まない。

Waiting for each minion to be registered with cloud provider
..................................................................

1時間待っても、2時間待っても状況変わらず。

どうやら、こちらの certificate 関連の厄介な問題に直面したようだ。

解決策は、1個前のバージョンである v1.0.1 にこちらのパッチを適用し、手動でインストールせよ、とのこと。


Kubernetes のインストール (リトライ)

まずは VM を初期化。

$ cd kubernetes
$ vagrant destroy -f
$ vagrant box remove kube-fedora21
$ cd ..
$ rm -rf ./kubernetes

Version 1.0.1 を手動でダウンロードしてから、パッチを適用。その後、インストール。

$ curl -LO https://github.com/kubernetes/kubernetes/releases/download/v1.0.1/kubernetes.tar.gz
$ tar zxvf ./kubernetes.tar.gz
$ cd kubernetes/cluster/vagrant
$ curl -O https://raw.githubusercontent.com/kubernetes/kubernetes/release-1.0/cluster/vagrant/provision-master.sh
$ curl -O https://raw.githubusercontent.com/kubernetes/kubernetes/release-1.0/cluster/vagrant/provision-minion.sh
$ cd ../..
$ export KUBERNETES_PROVIDER=vagrant
$ ./cluster/kube-up.sh

10分ほどで正常終了。ここまで長かった。

Cluster validation succeeded
Done, listing cluster services:

Kubernetes master is running at https://10.245.1.2
KubeDNS is running at https://10.245.1.2/api/v1/proxy/namespaces/kube-system/services/kube-dns
KubeUI is running at https://10.245.1.2/api/v1/proxy/namespaces/kube-system/services/kube-ui

API との疎通確認

$ ./cluster/kubectl.sh get pods
NAME      READY     STATUS    RESTARTS   AGE


Spark クラスタの起動

Spark マスターサービスの起動

$ ./cluster/kubectl.sh create -f ./examples/spark/spark-master.json
$ ./cluster/kubectl.sh create -f ./examples/spark/spark-master-service.json

暫く経つと Running になる。

$ ./cluster/kubectl.sh get pods
NAME           READY     STATUS    RESTARTS   AGE
spark-master   0/1       Pending   0          1m
$ ./cluster/kubectl.sh get pods
NAME           READY     STATUS    RESTARTS   AGE
spark-master   1/1       Running   0          15m
$ ./cluster/kubectl.sh logs spark-master

Spark ワーカーの起動

$ ./cluster/kubectl.sh create -f examples/spark/spark-worker-controller.json

15分経っても、3個中2個は Pending のままだった。

$ ./cluster/kubectl.sh get pods
NAME                            READY     STATUS    RESTARTS   AGE
spark-master                    1/1       Running   0          34m
spark-worker-controller-6cgpd   0/1       Pending   0          15m
spark-worker-controller-tqa4b   0/1       Pending   0          15m
spark-worker-controller-yl7n2   1/1       Running   0          15m
$ ./cluster/kubectl.sh get services
NAME           LABELS                                    SELECTOR            IP(S)           PORT(S)
kubernetes     component=apiserver,provider=kubernetes                 10.247.0.1      443/TCP
spark-master   name=spark-master                         name=spark-master   10.247.70.164   7077/TCP
$ ./cluster/kubectl.sh get nodes
NAME         LABELS                              STATUS
10.245.1.3   kubernetes.io/hostname=10.245.1.3   Ready


Spark を使う

spark-master の IPアドレスとポートを確認。

$ ./cluster/kubectl.sh get service spark-master
NAME           LABELS              SELECTOR            IP(S)           PORT(S)
spark-master   name=spark-master   name=spark-master   10.247.70.164   7077/TCP

Kubernetes の minion-1 にログインし、適当な Docker コンテナを起動。
その中で、環境変数や /etc/hosts ファイルを書き換えるユーティリティ用スクリプト setup_client.sh を(同一シェル内で)実行。

[vagrant@kubernetes-minion-1 ~]$ sudo docker run -it gcr.io/google_containers/spark-base
root@49cc6b98cb5f:/# . /setup_client.sh 10.247.70.164 7077

Kubernetes 上の Spark クラスタへアクセスしていることを確認できた。

root@49cc6b98cb5f:/# spark-shell
15/08/23 11:04:18 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /___/ .__/\_,_/_/ /_/\_\   version 1.4.0
      /_/

Using Scala version 2.10.4 (OpenJDK 64-Bit Server VM, Java 1.7.0_79)
Type in expressions to have them evaluated.
Type :help for more information.
Spark context available as sc.
15/08/23 11:04:31 WARN Connection: BoneCP specified but not present in CLASSPATH (or one of dependencies)
15/08/23 11:04:33 WARN Connection: BoneCP specified but not present in CLASSPATH (or one of dependencies)
15/08/23 11:04:43 WARN ObjectStore: Version information not found in metastore. hive.metastore.schema.verification is not enabled so recording the schema version 0.13.1aa
SQL context available as sqlContext.

scala> sc.isLocal
res0: Boolean = false

scala> sc.master
res1: String = spark://spark-master:7077

Python の API で、Spark ワーカーのホスト名を取得してみる。

root@49cc6b98cb5f:/# pyspark
Python 2.7.9 (default, Mar  1 2015, 12:57:24)
[GCC 4.9.2] on linux2
Type "help", "copyright", "credits" or "license" for more information.
15/08/23 11:12:06 WARN NativeCodeLoader: Unable to load native-hadoop library for your platform... using builtin-java classes where applicable
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /__ / .__/\_,_/_/ /_/\_\   version 1.4.0
      /_/

Using Python version 2.7.9 (default, Mar  1 2015 12:57:24)
SparkContext available as sc, HiveContext available as sqlContext.
>>> import socket
>>> sc.parallelize(range(1000)).map(lambda x:socket.gethostname()).distinct().collect()
['spark-worker-controller-yl7n2']


References